 Simone
Transformers(谷歌2017年提出的基于自注意力的神经网络架构)
的有关信息介绍如下: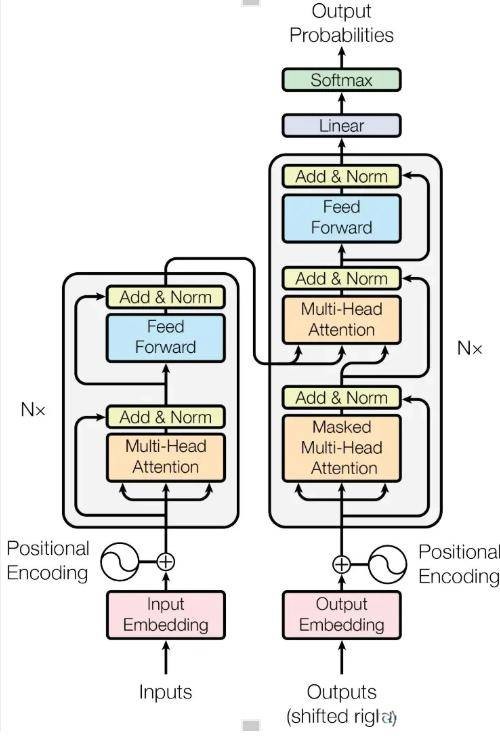
Transformers是由谷歌研究团队于2017年提出的深度学习架构,其核心创新是通过并行化序列处理和自注意力机制替代传统循环神经网络,解决了传统RNN在长序列训练中的效率瓶颈 。2025年12月,谷歌联合创始人谢尔盖·布林表示,Transformer论文发布时团队未予足够重视,并因担心聊天机器人表现而害怕展示 。
该架构不仅成为谷歌翻译、Gemini等产品的技术基础,还衍生出Vision Transformer(ViT)等跨模态应用,推动了计算机视觉领域的突破 。截至2024年,谷歌通过优化模型复杂度(如2022年推出的线性可扩展FLASH架构)和推出万亿参数规模的Switch Transformers(2021年发布,采用混合专家模型范式,参数规模达1.6万亿),持续保持其在生成式人工智能领域的竞争力 。Transformers的开源策略促进了TensorFlow、Gemma等生态发展,2024年发布的Gemma模型基于该架构提供两种参数规模版本,并与Hugging Face合作推动开源社区发展 。核心团队成员的流动(如三位ViT作者于2024年12月转投OpenAI)反映了行业竞争格局变化 。
该架构的持续创新方向包括改进长度外推能力、降低二次方复杂度等以应对长序列处理需求 。
想要了解更多“Transformers(谷歌2017年提出的基于自注意力的神经网络架构)”的信息,请点击:Transformers(谷歌2017年提出的基于自注意力的神经网络架构)百科